

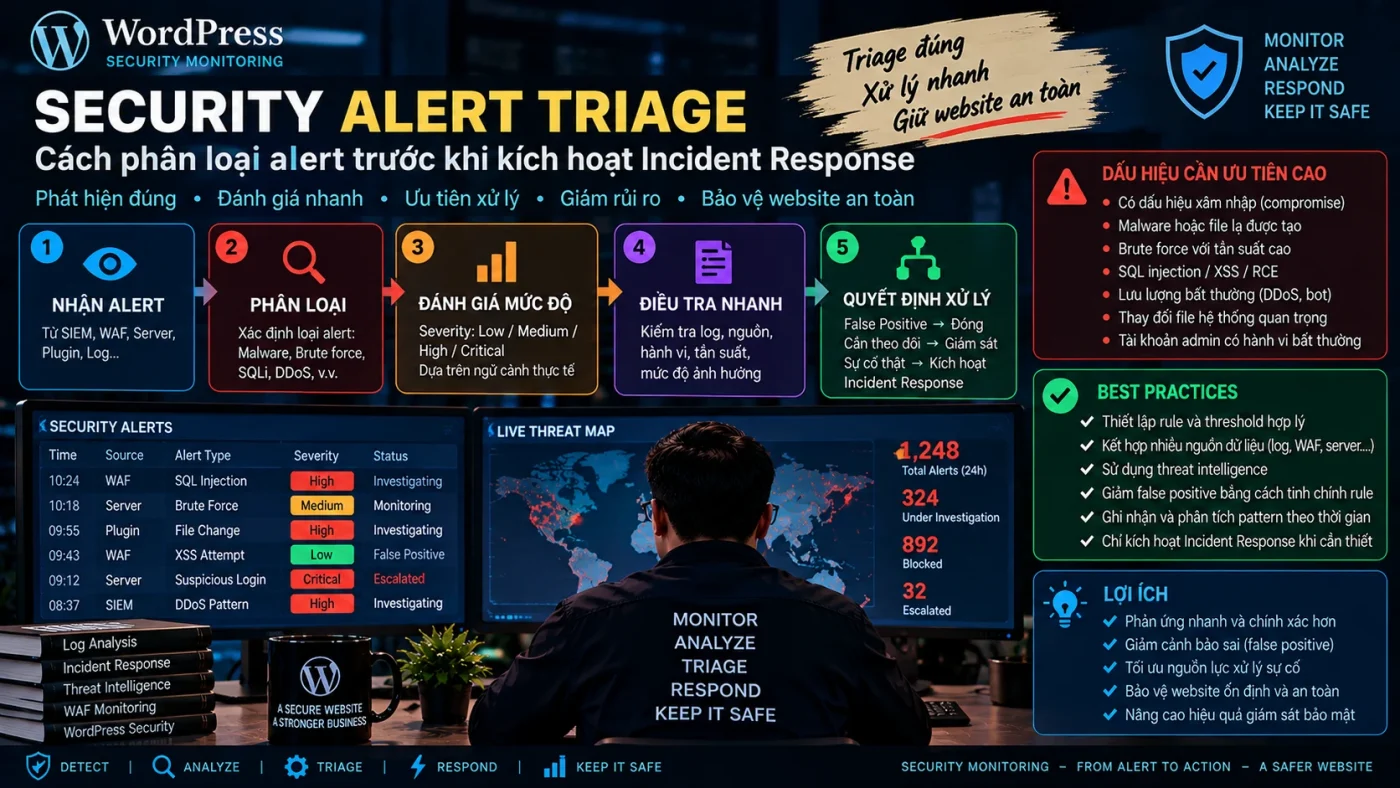
Alert fatigue xảy ra khi đội vận hành phải xử lý quá nhiều cảnh báo, trong đó phần lớn là noise, duplicate hoặc không actionable. Khi signal-to-noise ratio giảm, analyst dễ trì hoãn triage, bỏ qua escalation hoặc phản ứng chậm với một alert thực sự quan trọng.
Google SRE khuyến nghị alert phải actionable và chỉ nên đánh thức con người khi có hành động cụ thể cần thực hiện; alert không actionable sẽ tạo noise và làm tăng nguy cơ alert fatigue. Microsoft cũng ghi nhận SOC xử lý lượng alert lớn có thể bỏ lỡ high-risk activity khi thời gian bị tiêu tốn cho false alarms và triage không nhất quán. Nguồn: Google SRE — Monitoring Distributed Systems và Microsoft Defender — Security Alert Triage.
Bối cảnh và dấu hiệu alert fatigue
Giả sử một website đang được giám sát bởi WAF, server monitoring, WordPress activity log và endpoint/security tooling. Mỗi ngày hệ thống tạo hàng trăm alert: bot scan, failed login, health-check fluctuation, blocked request, file-change noise và các rule lặp lại. Trong khối lượng đó xuất hiện một alert về admin login bất thường, nhưng alert bị xử lý chậm vì queue đã quá tải.
Những tín hiệu cần chú ý
- Số alert tăng nhưng số incident thực tế không tăng tương ứng.
- Nhiều alert duplicate cho cùng một event hoặc entity.
- Alert không có owner, runbook hoặc next action rõ ràng.
- Analyst thường xuyên mute/snooze rule mà không review lại.
- High-severity alert nằm trong queue lâu hơn SLA.
- Escalation chỉ phụ thuộc vào việc analyst “nhìn thấy” alert đúng lúc.
Investigation: vì sao alert quan trọng bị bỏ qua?
Bước 1: đo signal-to-noise theo rule và nguồn
Không nên đánh giá alert fatigue bằng cảm giác. Cần đo số alert theo rule, false positive/benign true positive rate, duplicate rate, time-to-triage, time-to-escalate và số alert được đóng mà không điều tra. Rule tạo nhiều volume nhưng ít giá trị nên được review trước.
Google SRE khuyến nghị rà soát alert bằng câu hỏi: điều kiện này có urgent, actionable và user-impacting không; nếu alert thường xuyên có thể bị bỏ qua vì benign thì rule cần được chỉnh để tránh pager burnout.
Bước 2: kiểm tra triage context
Một alert đơn lẻ thường thiếu context. Cần bổ sung asset criticality, user/entity, source IP, baseline, recent changes và các alert liên quan. Microsoft hiện khuyến nghị tuning alert để tự động resolve benign true positives hoặc false positives, đồng thời dùng correlation/aggregation để giảm số alert analyst phải triage.
Bước 3: kiểm tra routing và escalation
Alert có severity cao nhưng không có route tới đúng owner vẫn có thể bị bỏ qua. Cần xác định channel, on-call owner, escalation timeout và điều kiện chuyển alert thành incident. Nếu escalation chỉ dựa vào inbox chung hoặc dashboard không người trực, risk vẫn cao dù detection rule đúng.
Xem thêm Security Monitoring WordPress, Website Security Monitoring và Managed Website Security để chuẩn hóa signal, triage và response ownership.
Khi nào có thể xác nhận alert fatigue là nguyên nhân vận hành?
Không nên kết luận chỉ vì alert volume cao. Alert fatigue trở thành finding khi volume/noise thực sự làm giảm khả năng phản ứng với signal quan trọng.
- High-value alert bị triage hoặc escalate trễ vì queue/noise.
- Rule có false-positive hoặc duplicate rate cao kéo dài.
- Analyst thường xuyên bỏ qua cùng nhóm alert benign.
- Không có automation/correlation cho alert lặp lại.
- Time-to-triage vượt SLA trong ca trực có volume cao.
Remediation: giảm noise nhưng không làm mất coverage
Tune rule theo tính actionable
- Loại bỏ rule không có hành động cụ thể.
- Điều chỉnh threshold hoặc duration để giảm alert flapping.
- Dùng allowlist/context cho benign activity đã xác minh.
- Gom duplicate events thành một incident/case.
- Tách page/urgent alert khỏi ticket/non-urgent signal.
Google SRE nhấn mạnh rằng paging alert nên actionable và noise thấp; Microsoft Defender cũng hỗ trợ alert tuning/aggregation để giảm số alert cần triage mà vẫn giữ các signal quan trọng.
Thiết kế escalation có SLA và owner
- High/Critical alert phải có owner hoặc on-call route rõ ràng.
- Đặt timeout trước khi auto-escalate sang cấp tiếp theo.
- Gắn runbook và minimum evidence vào alert.
- Automation chỉ xử lý task lặp lại có logic rõ, không thay analyst ở quyết định cần judgment.
- Review rule định kỳ để bắt configuration drift và thay đổi baseline.
Validation sau alert tuning
| Chỉ số | Kết quả mong đợi |
|---|---|
| Alert volume | Giảm ở nhóm noise/duplicate |
| High-value detection | Không giảm coverage quan trọng |
| False-positive rate | Giảm theo từng rule |
| Time-to-triage | Giảm và nằm trong SLA |
| Time-to-escalate | Không phụ thuộc vào inbox/manual discovery |
| Missed alerts | Không còn alert critical bị bỏ qua do queue overload |
Bài học vận hành và bước tiếp theo
- Alert nhiều không đồng nghĩa monitoring tốt.
- Rule không actionable tạo operational load và làm giảm attention cho signal quan trọng.
- Correlation và aggregation giúp giảm duplicate mà không nhất thiết giảm coverage.
- Severity cần đi cùng context, owner và escalation path.
- Alert tuning phải có regression check để tránh tạo false negative.
- Monitoring program cần review định kỳ thay vì cấu hình một lần rồi để nguyên.