

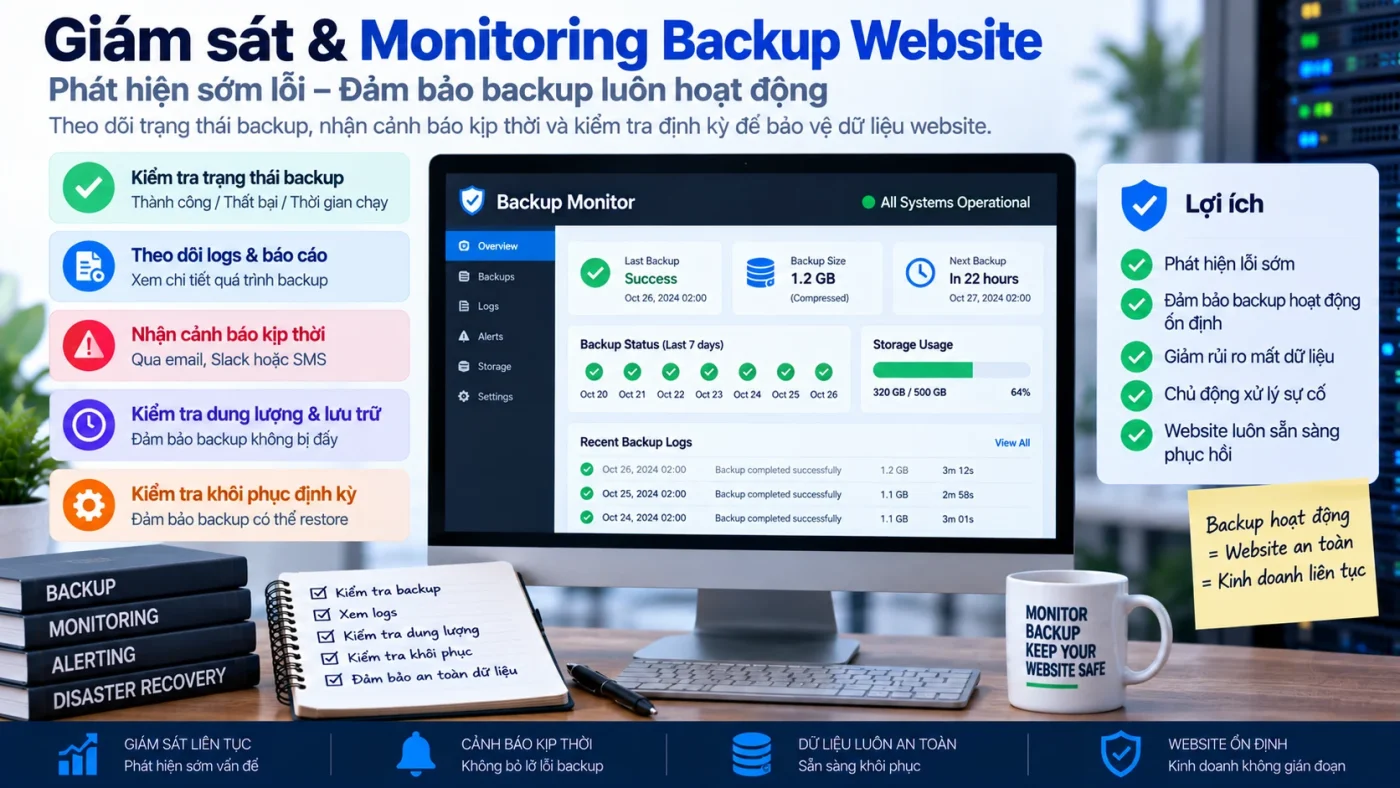
Backup có thể âm thầm mất tác dụng dù dashboard trước đó từng báo thành công. Khi backup job thất bại liên tiếp nhưng không có alert, không có owner hoặc không ai theo dõi restore-point freshness, hệ thống có thể trượt xa khỏi RPO trong nhiều ngày mà đội vận hành vẫn tưởng recovery capability còn nguyên.
NIST SP 1339 năm 2026 nhấn mạnh backup phải được tạo đều, test và review trong recovery exercise. AWS Backup cũng phân biệt rõ trạng thái job và cho phép phát sự kiện khi backup FAILED; AWS lưu ý một failed backup job đồng nghĩa không có recovery point được tạo. Với WordPress, full recovery thông thường cần cả files và database. Vì vậy kiểm soát backup không thể dừng ở “đã cấu hình lịch chạy”. Nguồn: NIST SP 1339, AWS Backup — EventBridge monitoring và WordPress — Backups.
Bối cảnh: backup job fail nhưng không ai biết
Giả sử website chạy backup mỗi đêm. Một thay đổi credential hoặc storage policy khiến job bắt đầu fail từ đầu tháng, nhưng notification channel không còn hoạt động và dashboard không được review. Ba tuần sau, production gặp sự cố; lúc đó đội vận hành mới phát hiện restore point gần nhất đã cũ nhiều tuần.
Những dấu hiệu của “silent backup failure”
- Job scheduler vẫn chạy nhưng kết quả chuyển sang FAILED/ABORTED.
- Không có alert khi recovery point mới không được tạo.
- Dashboard chỉ được kiểm tra khi xảy ra incident.
- Không có owner chịu trách nhiệm acknowledge backup failure.
- RPO được khai báo nhưng không có freshness check tự động.
- Backup job success không được đối chiếu bằng restore test hoặc integrity check.
Investigation: xác định gap nằm ở job, storage hay monitoring
Bước 1: đọc job history và recovery-point timeline
Không chỉ kiểm tra scheduler có chạy hay không. Cần xem trạng thái từng job, error message, bytes transferred, target repository và quan trọng nhất là recovery point thực tế có được tạo hay không. AWS Backup hỗ trợ theo dõi các trạng thái như FAILED, COMPLETED, RUNNING, ABORTED và phát event khi state thay đổi.
Timeline nên trả lời hai câu hỏi: lần backup usable gần nhất là khi nào, và từ thời điểm nào job bắt đầu fail. Chênh lệch đó chính là recovery gap thực tế cần so với RPO.
Bước 2: xác định root cause của job failure
Backup job có thể fail vì storage quota, credential/token hết hạn, permission thay đổi, repository unreachable, database dump lỗi, file permission, network timeout hoặc target path bị đổi. Root cause phải được xác minh bằng job logs và trạng thái repository thay vì chỉ retry job.
Nếu backup gồm cả WordPress files và database, cần kiểm tra hai luồng riêng. WordPress nhấn mạnh database và files là hai thành phần tách biệt; một job “partial success” vẫn không tạo thành full-site backup usable nếu thiếu một phần bắt buộc.
Bước 3: điều tra vì sao failure không được phát hiện
Đây là phần phân biệt incident vận hành với một lỗi backup đơn lẻ. Cần kiểm tra notification rule, alert destination, escalation owner, dashboard review cadence và freshness threshold. Nếu job fail đúng nhưng event không tới người chịu trách nhiệm, control gap nằm ở monitoring/ownership chứ không chỉ ở backup engine.
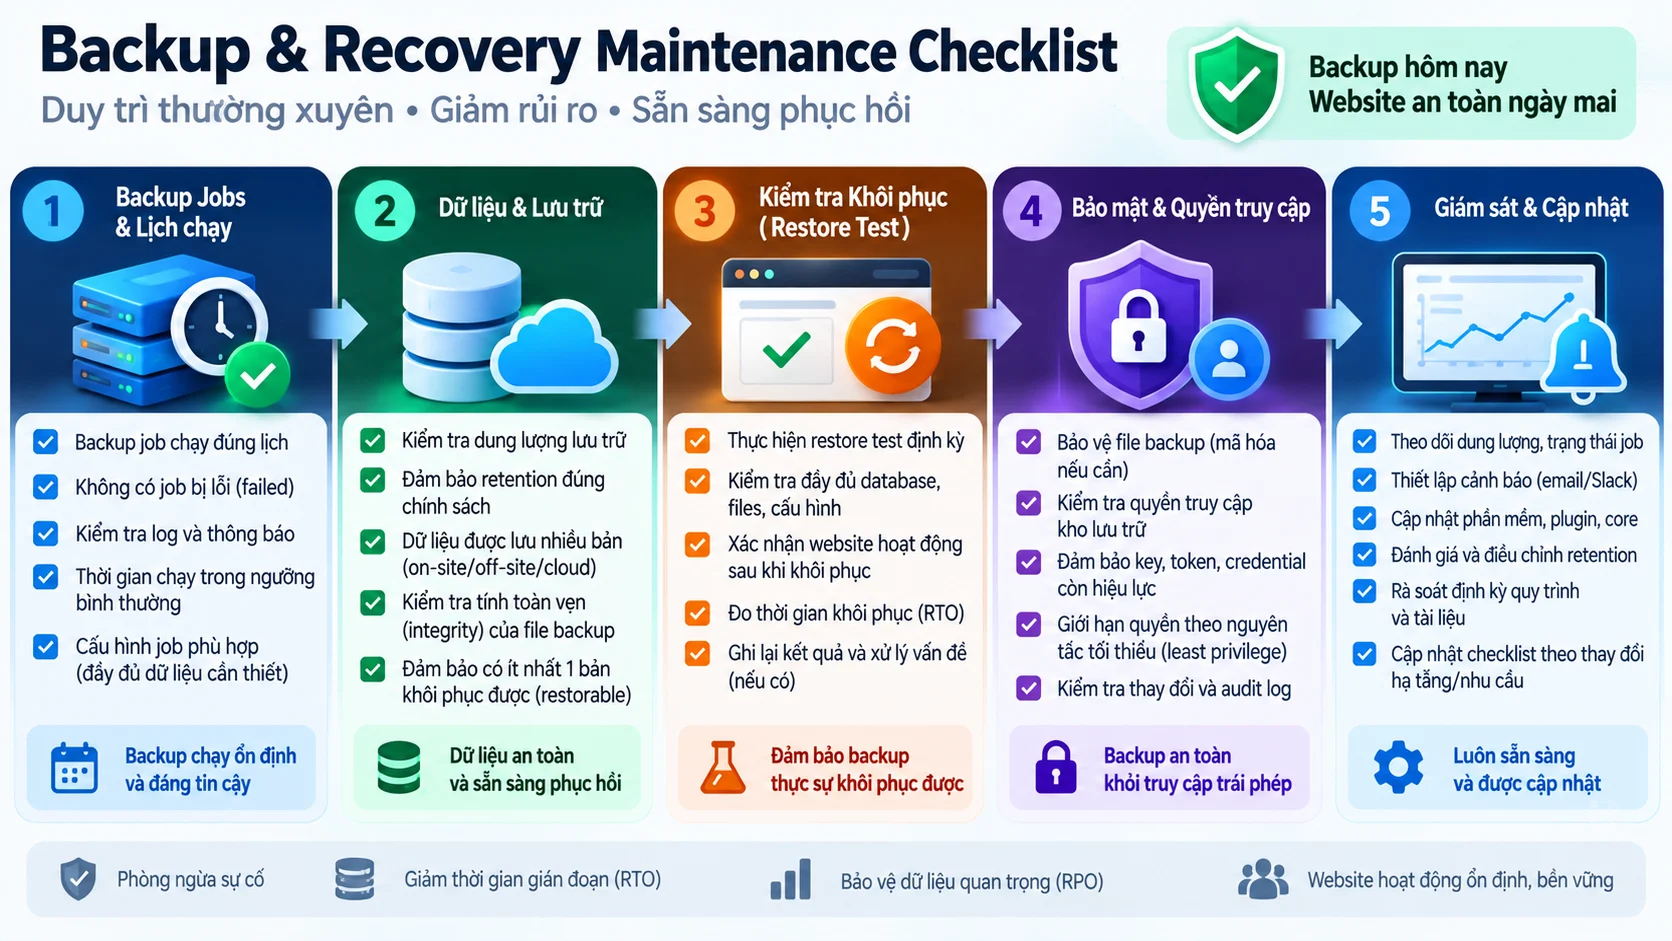
Đọc thêm Backup Monitoring, Backup & Recovery Maintenance Checklist và Website Backup Strategy để chuẩn hóa job health, freshness, restore readiness và owner.
Khi nào có thể xác nhận backup monitoring đã thất bại?
Không nên kết luận chỉ vì một job fail mà không ai thấy ngay lập tức. Monitoring failure cần được chứng minh bằng khoảng thời gian backup mất khả năng bảo vệ nhưng control giám sát không tạo hành động phù hợp.
- Nhiều backup job liên tiếp FAILED/ABORTED.
- Không có recovery point mới trong khoảng vượt RPO.
- Không có alert được delivered/acknowledged cho owner.
- Dashboard hoặc health check không phát hiện freshness gap.
- Sự cố chỉ được phát hiện khi cần restore hoặc review thủ công.
Remediation: monitor recovery capability, không chỉ monitor scheduler
Thiết kế alert theo failure và freshness
- Alert ngay khi backup job FAILED/ABORTED.
- Alert khi không có successful recovery point mới trong ngưỡng RPO.
- Alert riêng cho storage quota/repository unreachable.
- Gửi alert tới owner/on-call channel có acknowledgement.
- Escalate khi failure lặp lại hoặc không được acknowledge trong SLA.
AWS Backup hỗ trợ EventBridge, CloudWatch và SNS để theo dõi job state và tạo alarm. Nguyên tắc có thể áp dụng cho mọi backup stack: monitoring phải dựa trên outcome và recovery-point freshness, không chỉ dựa trên việc cron/scheduler đã chạy.
Thêm verification gate định kỳ
NIST SP 1339 nhấn mạnh backup cần được test và review trong recovery exercise. Vì vậy ngoài job health, cần kiểm tra integrity và restore usability theo cadence phù hợp với criticality. Một job COMPLETED nhưng artifact hỏng vẫn là recovery failure.
Maintenance review nên bao gồm success rate, latest recovery point, repository health, retention, restore test, RPO/RTO và owner. Dùng Backup & Recovery Maintenance Checklist làm baseline định kỳ.
Validation sau khi sửa backup pipeline
| Kiểm tra | Kết quả mong đợi |
|---|---|
| Backup job | Successful theo lịch dự kiến |
| Recovery-point freshness | Không vượt ngưỡng RPO |
| Failure alert | Được gửi và acknowledge đúng owner |
| Repository/storage | Còn capacity và truy cập ổn định |
| Files + database | Đủ thành phần cho full restore |
| Restore test | Artifact có thể khôi phục trong môi trường test |
| Escalation | Repeated failure được nâng cấp theo SLA |
Bài học vận hành và bước tiếp theo
- Backup scheduler chạy không chứng minh recovery point đã được tạo.
- RPO cần được monitor bằng freshness của recovery point thực tế.
- Failed job phải tạo alert có owner và acknowledgement.
- Files và database cần được theo dõi như một backup set hoàn chỉnh.
- Job success không thay thế integrity/restore test.
- Backup monitoring nên được review sau mọi thay đổi credential, storage, hosting hoặc architecture.