

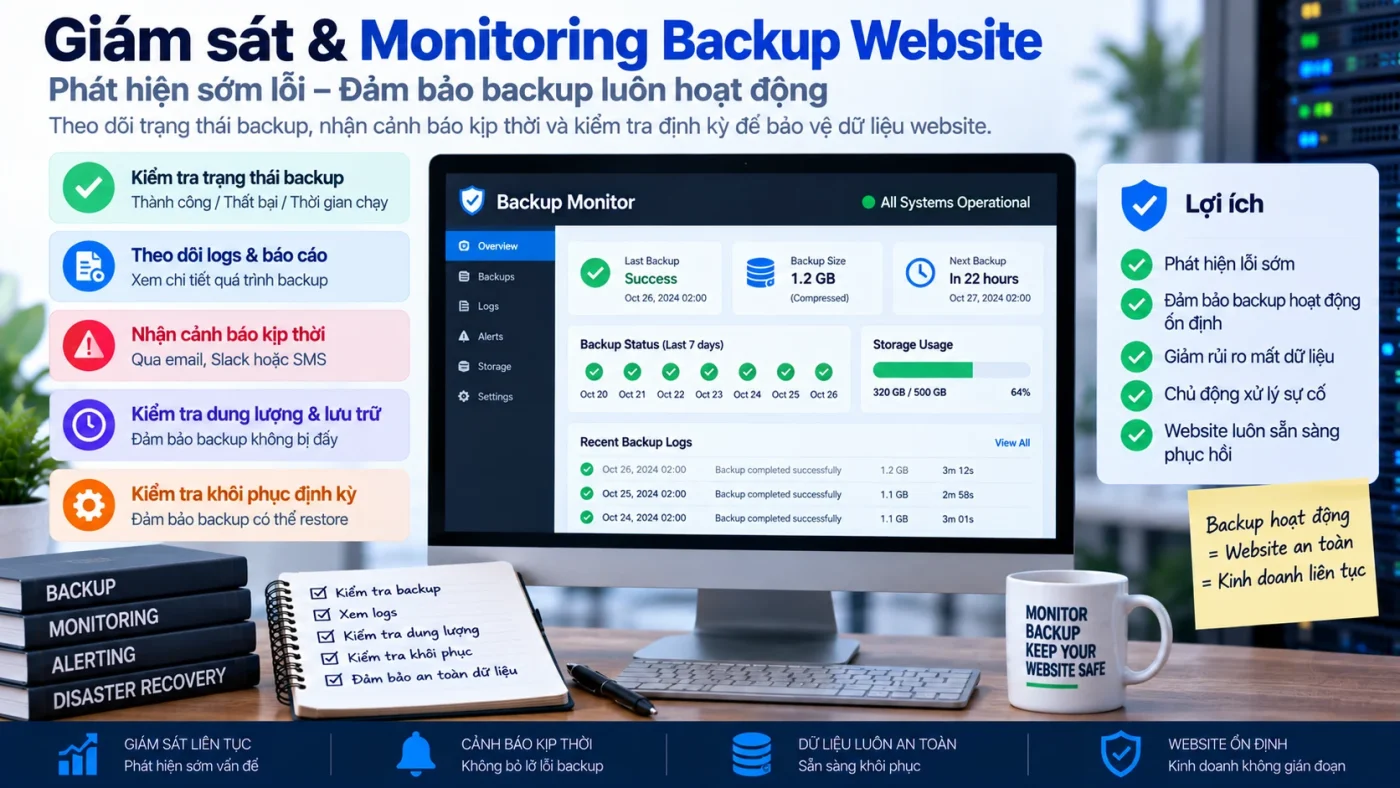
Backup Monitoring là việc theo dõi liên tục để phát hiện hệ thống backup bị lỗi, ngừng chạy, mất telemetry, vượt RPO, thiếu dung lượng hoặc tạo ra restore point không còn đáng tin. Một job được cấu hình “chạy mỗi ngày” không có nghĩa là mỗi ngày đều có một backup usable.
Mục tiêu của monitoring là trả lời nhanh ba câu hỏi: backup gần nhất có được tạo đúng hạn không, repository có còn khỏe không, và khi cần recovery thì restore point có đủ điều kiện sử dụng không?
Vì sao chỉ theo dõi trạng thái “Success” là chưa đủ?
Backup software có thể báo job success nhưng dữ liệu bị thiếu, archive bất thường, retention bị thay đổi, storage gần đầy hoặc restore point mới nhất đã quá tuổi so với RPO. Ngược lại, một job fail tạm thời chưa chắc tạo business impact nếu vẫn còn restore point trong mục tiêu cho phép.
Vì vậy dashboard backup phải kết hợp job health + freshness + integrity + repository health + recovery readiness.
Các tín hiệu Backup Monitoring cần theo dõi
Signal 1: tuổi của restore point gần nhất
Last successful backup age là signal quan trọng nhất để biết backup có đang đáp ứng frequency/RPO hay không. Nếu business-approved RPO là 4 giờ nhưng restore point gần nhất đã 7 giờ, monitoring phải coi đó là gap dù cron vẫn tồn tại.
Để xác định threshold theo business impact, xem RPO và RTO cho website và cách chọn tần suất backup.
Signal 2: job status và missed schedule
Theo dõi success, warning, failure, duration và missed schedule. Một số tình huống cần alert:
- Job không chạy tại thời điểm dự kiến.
- Job fail liên tiếp.
- Duration tăng đột biến.
- Job hoàn tất quá nhanh so với baseline và backup size giảm mạnh.
- Job bị disable hoặc schedule bị sửa.
Missed schedule thường nguy hiểm hơn một failure có alert rõ vì hệ thống có thể im lặng không tạo event.
Signal 3: backup size và object/file count
Backup size không phải KPI chất lượng, nhưng deviation bất thường có thể chỉ ra scope bị thay đổi, database export rỗng, uploads bị bỏ qua hoặc compression/tooling thay đổi.
Không dùng một threshold cố định cho mọi site. So sánh với baseline, change rate và deployment context. Nếu site vừa xóa hàng nghìn media hợp lệ, size giảm có thể bình thường.
Signal 4: repository capacity và storage health
Backup có thể thất bại vì storage đầy, quota, credential hết hạn, object lock/retention conflict hoặc network/egress problem. Theo dõi:
- Free space/quota.
- Write/read error.
- Repository reachability.
- Credential/authentication failure.
- Encryption/key error.
- Retention/object-lock error.
- Replication/offsite-copy lag.
Với offsite architecture, xem Offsite Backup và Backup Security.
Signal 5: retention và deletion event
Monitoring không nên chỉ quan sát creation. Retention policy bị rút ngắn, object bị xóa hàng loạt hoặc admin thay immutable setting có thể phá recovery history dù backup jobs vẫn chạy.
Alert nên ưu tiên:
- Mass deletion.
- Retention policy change.
- Immutability/object-lock change.
- New admin hoặc privilege escalation trên repository.
- Unexpected lifecycle rule.
Signal 6: integrity và restore-test result
CISA khuyến nghị kiểm thử định kỳ availability và integrity của backups trong disaster-recovery scenario. Vì vậy monitoring nên lưu trạng thái restore test gần nhất, không chỉ trạng thái backup job.
Các metric hữu ích gồm:
- Ngày restore test gần nhất.
- Restore point được test.
- Integrity PASS/FAIL.
- Database import PASS/FAIL.
- Business-flow smoke test PASS/FAIL.
- Observed RPO/RTO.
Quy trình test chi tiết nằm ở kiểm tra backup có restore được không.
Signal 7: telemetry health của chính backup monitoring
Một monitoring pipeline có thể tự bị hỏng. Cần biết collector hoặc API cuối cùng gửi event lúc nào, parser có lỗi không và alert channel có hoạt động không.
Nếu dashboard hiển thị “0 failure” nhưng source đã im lặng 3 ngày, đó không phải PASS. Đây là cùng nguyên tắc với Security Monitoring Dashboard: phải giám sát cả health của telemetry.
Alerting và operational response
Severity cho backup alert
| Ví dụ | Severity gợi ý | Lý do |
|---|---|---|
| Một job fail nhưng restore point vẫn trong RPO | Medium | Cần xử lý trước khi gap tăng |
| Restore point đã vượt RPO | High | Recovery objective không còn được đáp ứng |
| Repository unreachable + không còn copy khác | High/Critical | Recovery path có thể mất |
| Mass deletion/retention change trái phép | Critical | Có thể là compromise hoặc phá recovery layer |
| Restore test fail | High | Backup tồn tại nhưng usability chưa chứng minh |
Severity thực tế phải dựa vào business impact và redundancy. Không hard-code cùng severity cho mọi website.
Alert routing và owner
Mỗi backup alert cần owner và action rõ. Alert “backup failed” gửi vào email không ai đọc không tạo ra control thực tế.
Thiết kế rule theo Security Alerting: rule, threshold và severity. Tối thiểu alert phải có asset, backup job, last-good timestamp, severity, evidence link và next action.
Backup Monitoring Dashboard tối thiểu
| Widget | Metric | Action khi lệch |
|---|---|---|
| Freshness | Age of last successful restore point | Retry/escalate trước khi vượt RPO |
| Job health | Success/fail/missed/duration | Kiểm tra scheduler/tool/source |
| Scope anomaly | Backup size/object count deviation | Xác minh backup scope |
| Repository | Capacity/auth/write/read health | Khôi phục storage path |
| Retention | Delete/policy/lock changes | Review owner và authorization |
| Restore readiness | Last restore test + result | Test lại/remediate |
Operational artifact: Backup Monitoring Record
asset: <website>
backup_job: <name>
owner: <team/person>
rpo_target: <time>
expected_schedule: <schedule>
last_successful_restore_point: <timestamp>
restore_point_age: <duration>
job_status: success|warning|fail|missed
backup_size: <value>
repository_health: PASS|FAIL
retention_change: none|expected|unexpected
last_restore_test: <date/result>
telemetry_last_seen: <timestamp>
alert_status: open|acknowledged|resolved
next_action: <action>
Quality gate cho Backup Monitoring
- Có alert khi restore-point age vượt threshold gắn với RPO.
- Missed schedule được phát hiện, không chỉ explicit failure.
- Repository health và capacity được giám sát.
- Retention/delete/control-plane change có audit hoặc alert phù hợp.
- Restore-test result xuất hiện trong monitoring state.
- Telemetry health được giám sát.
- Mỗi alert có owner và runbook/action.
Nguồn kỹ thuật
- CISA StopRansomware Guide.
- CISA Cyber Resilience Review — Question Set with Guidance.
- NIST SP 800-209 — Security Guidelines for Storage Infrastructure.
Kết luận
Backup Monitoring phải chứng minh rằng recovery layer vẫn hoạt động theo thời gian. Theo dõi job status là chưa đủ; cần quan sát restore-point freshness, repository health, retention/deletion, integrity test và telemetry health. Khi một trong các lớp này lệch khỏi mục tiêu, alert phải dẫn tới action có owner trước khi sự cố thật xảy ra.