

Remediation backlog trở thành rủi ro khi finding được phát hiện nhưng không được xử lý, không có owner rõ ràng, liên tục trượt SLA hoặc bị đóng mà chưa có bằng chứng retest. Khi backlog tích tụ, cùng một weakness có thể xuất hiện lặp lại qua nhiều audit cycle, nhiều asset hoặc nhiều incident khác nhau.
NIST mô tả patch management như một chu trình gồm nhận diện, ưu tiên, cài đặt và xác minh patch; mục tiêu không chỉ là “có kế hoạch sửa” mà là giảm rủi ro thông qua một quy trình lặp lại và có thể vận hành. Tenable cũng coi remediation tracking là việc theo dõi toàn bộ lifecycle từ discovery đến resolution, với SLA gắn với mục tiêu kinh doanh và mức độ quan trọng của asset. Nguồn: NIST SP 800-40 Rev.4 và Tenable — Remediation Tracking.
Bối cảnh và tín hiệu backlog đang trở thành rủi ro
Giả sử một website đã qua nhiều vòng audit. Mỗi vòng đều phát hiện một số finding High và Medium liên quan plugin cũ, security headers, admin account, exposed service hoặc patch chưa áp. Một phần finding được fix, phần còn lại bị dời sang “sprint sau”. Sau vài tháng, backlog gồm hàng chục item với owner, deadline và trạng thái không còn nhất quán.
Vấn đề không chỉ là số lượng finding. Rủi ro tăng khi backlog chứa item aging lâu, repeated finding, asset quan trọng, internet-facing exposure hoặc issue đã có exploit/known exploitation nhưng vẫn không được ưu tiên đúng mức.
Những dấu hiệu cần escalation
- Finding quá SLA nhưng không có risk acceptance hoặc owner xác nhận.
- Cùng weakness xuất hiện lại trong nhiều audit/retest cycle.
- Critical/High finding tồn tại trên asset internet-facing hoặc business-critical.
- Ticket ở trạng thái Done nhưng chưa có read-back/retest evidence.
- Backlog có nhiều duplicate hoặc finding không còn gắn với asset owner hiện tại.
- Remediation liên tục bị trì hoãn vì dependency nhưng không có kế hoạch xử lý dependency.
Investigation: backlog đang tồn ở đâu và vì sao?
Bước 1: chuẩn hóa finding inventory
Đầu tiên cần hợp nhất finding theo asset, weakness/CVE, severity, exposure, owner, ngày phát hiện, SLA, remediation status và retest status. Nếu cùng một weakness xuất hiện trên nhiều asset, nên tách giữa root cause chung và từng finding instance để tránh vừa duplicate vừa bỏ sót phạm vi.
Backlog không nên là một danh sách phẳng. Cần phân biệt finding mới, đang remediation, blocked, accepted risk, pending retest và verified closed. Trạng thái mơ hồ như “in progress” kéo dài nhiều tuần làm mất khả năng đo hiệu quả chương trình.
Bước 2: tìm aging, repeated finding và owner gap
Tenable nhấn mạnh SLA compliance là thành phần quan trọng của vulnerability management, nhưng không có một thời hạn cố định phù hợp cho mọi tổ chức. Remediation timeframe cần gắn với business objective, asset criticality và mức độ ưu tiên. Vì vậy backlog review nên nhìn cả aging theo SLA lẫn risk context thay vì chỉ đếm số ticket quá hạn.
Một finding lặp lại sau nhiều audit thường cho thấy control ở cấp hệ thống chưa được sửa: patch process yếu, baseline không được enforce, decommission không hoàn tất hoặc ownership không rõ. Đây là tín hiệu cần root-cause action thay vì tiếp tục đóng từng ticket riêng lẻ.
Bước 3: xác định remediation bottleneck
Backlog thường tồn đọng vì một trong các nguyên nhân: không rõ owner, thiếu maintenance window, sợ downtime, dependency với vendor, remediation quá lớn, thiếu staging/retest hoặc severity không phản ánh đúng business impact. Cần ghi rõ blocker và người có quyền tháo blocker.
Đọc thêm Security Remediation Backlog, Managed Security SLA và Security Finding Severity để chuẩn hóa owner, SLA và risk context.
Khi nào backlog cần được coi là systemic risk?
Không phải backlog nào cũng nghiêm trọng như nhau. Một số finding có thể chờ theo kế hoạch nếu exposure thấp và compensating controls tốt. Backlog trở thành systemic risk khi nhiều tín hiệu cùng xuất hiện.
- Tỷ lệ overdue tăng liên tục qua các kỳ review.
- High/Critical finding quá hạn trên asset quan trọng.
- Repeated finding xuất hiện lại sau remediation hoặc audit cycle mới.
- Không có owner hoặc owner không có authority để triển khai fix.
- Blocked item không có escalation path hoặc deadline xử lý dependency.
- Finding được đóng mà không có verification evidence.
Remediation: giảm backlog theo risk, không theo FIFO
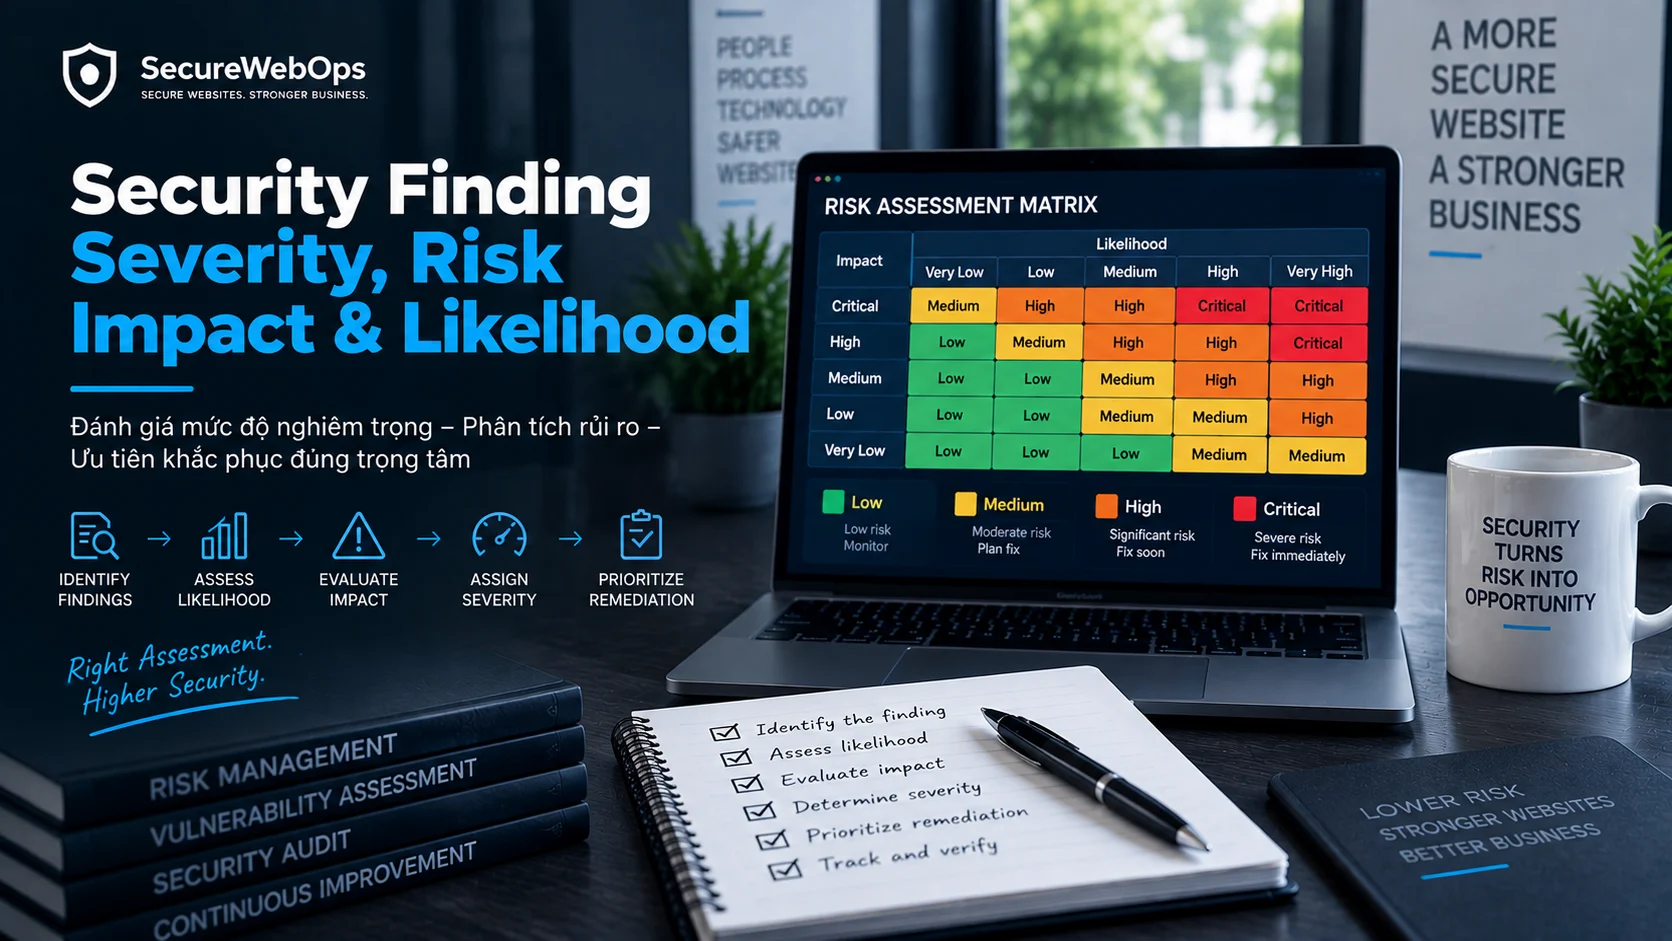
Ưu tiên finding theo risk context
- Ưu tiên internet-facing và business-critical asset trước.
- Tăng priority cho finding có known exploitation, exploitability cao hoặc blast radius lớn.
- Gom recurring issue thành root-cause remediation thay vì xử lý từng symptom.
- Đặt SLA khác nhau theo severity, asset criticality và exposure.
- Không để Medium/Low tồn tại vô hạn nếu chúng lặp lại hoặc cộng dồn thành attack path.
NIST khuyến nghị xây dựng chiến lược enterprise patch management để việc ưu tiên, triển khai và xác minh patch trở thành preventive maintenance có hệ thống. Tenable cũng khuyến nghị remediation timeframe gắn với business objective và asset importance, thay vì một deadline giống nhau cho mọi vulnerability.
Thiết lập closure gate và escalation
- Finding chỉ chuyển Closed khi có read-back/retest evidence.
- Overdue item phải có escalation owner và lý do trì hoãn.
- Accepted risk phải có approver, expiry/review date và compensating controls.
- Blocked item phải có dependency owner và next action cụ thể.
- Repeated finding phải tạo action ở cấp process/baseline thay vì chỉ reopen ticket cũ.
Quy trình đóng finding nên tham chiếu case retest phát hiện remediation chưa hoàn tất để tránh tình trạng “ticket done nhưng vulnerability vẫn tồn tại”.
Validation: đo backlog đã thực sự giảm rủi ro chưa
| Chỉ số | Kết quả mong đợi |
|---|---|
| Overdue High/Critical | Giảm theo từng kỳ review |
| Mean/median age | Không tăng kéo dài |
| Repeated findings | Giảm sau root-cause remediation |
| Owner coverage | Mọi finding có owner rõ ràng |
| Blocked findings | Có escalation path và next action |
| Verified closure rate | Closure đi kèm retest/read-back evidence |
| Risk acceptance | Có approver và review/expiry date |
Bài học vận hành và bước tiếp theo
- Backlog là risk register đang sống, không phải kho ticket cũ.
- FIFO không phù hợp bằng risk-based prioritization.
- Repeated finding thường phản ánh control/process failure ở cấp hệ thống.
- SLA cần gắn với asset criticality và business objective.
- Blocked item phải có escalation owner thay vì nằm yên trong backlog.
- Đóng finding không có retest evidence dễ tạo cảm giác an toàn giả.